SAP
Business Objects Data Services
por Gláucia
Sibele
O BO Data Services é um software que
permite planejar, organizar, desenvolver e administrar de forma visual os
processos de ETL.
Benefícios:
•
Facilita o processo de
organização de dados de diferentes fontes através de uma interface gráfica.
•
Extrai, transforma e carrega
os dados de fontes heterogenias em um único banco de dados usando processos que
organizam os fluxos de carga.
•
Compartilha objetos em um
ambiente de ETL onde exista mais de um desenvolvedor.
•
Permite a administração
dos projetos via WEB.
Arquitetura do Data Services:
O SAP BO
Data Services contêm diversos componentes para desenvolver e administrar as
rotinas de ETL, sendo eles:
•
Designer:
o Interface de desenvolvimento para criar,
testar e executar manualmente os processos de ETL.
•
Repository Manager:
o
Permite criar,
atualizar e verificar as versões dos repositórios locais e Central.
–
Repositório Local: Armazena
as definições dos
objetos do Data Services Designer (como projetos, jobs, work flows e data
flows) e metadados de origem/destino.
§ Cada desenvolvedor deve ter seu repositório
local, ou seja, o repositório é individual
• Repositório Central: Componente opcional
utilizado para apoiar o desenvolvimento multiusuário.
•
Funciona como um
SharePoint => Controla a versão dos objetos desenvolvidos.
•
Apenas um repositório
central para todos os desenvolvedores. Deve-se criar o repositório Central com
segurança para que apenas usuários cadastrados tenham o acesso ao projeto e
Jobs desenvolvidos.
o
Repositórios devem
estar criados no servidor de banco de dados.
•
Server Manager:
o
Responsável
pela execução dos Jobs do Data Services Designer. Nele vinculam-se os
repositórios locais para execução e configuração SMTP para envio de e-mail.
•
Management
Console
o Provê a administração e gerenciamento dos recursos
do Data Services Designer via WEB. Nele é possível:
–
Agendamento, monitoramento
e execução dos Batch jobs
–
Interrupção da execução
dos Batch Jobs
–
Configuração dos
Repositórios Locais
–
Configuração do
Repositório Central
–
Criação dos grupos e usuários
para acesso ao Repositório Central
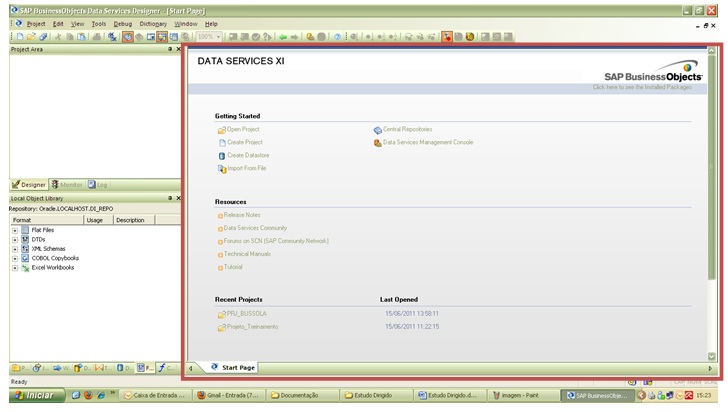
1. Data Services Designer
Interface do Data Services Designer, possui:
- Barra de
menu
- Project
Area,
- Local Object Library
- Star Page.

} Project
Area: Possibilita visualizar
os Jobs vinculados ao projeto, como também monitorar e verificar o log de
execução. Contêm as seguintes abas.
•
Designer: Criar, visualizar
e gerenciar projetos. Fornece uma visão hierárquica de todos os objetos
utilizados no processo.
• Monitor: Exibi o status das execuções dos Jobs e possibilita finalizar o processo
durante a execução.
•
Log: Local onde se
visualiza o histórico completo de execução dos jobs. Também podem ser visualizados com o Data Services Management Console.

} Local
Object Library
Job: Objeto
executável. Pode conter:
·
Scripts: Para envio de
e-mail, deleção de registros no banco de dados, habilitar e desabilitar índices
e demais verificações necessárias em banco de dados e etc.
·
Conditional: Objeto utilizado
para uma condição de execução do processo.
·
Work Flow: Objeto onde
seqüencia-se e ordena-se o fluxo de execução. Composto por Data Flows. Também é
utilizado para definir estratégias de tratamento de erros que possam ocorrer
durante a execução do Job (bloco Try/Catch).
·
Data Flow: Processo pelo qual
os dados de origem são transformados e carregados no destino. Envolve a
extração o tratamento e a transferência dos dados de origem de uma ou mais
fontes para uma ou mais tabelas ou arquivos de destino.
Projects: Agrupa os Jobs do processo de ETL.
•
Os
Jobs devem ser associados a um projeto antes de
serem executados na área de Projeto (Project Area) do Designer para que se
possa monitorar e/ou cancelar o processo.
Datastore: Configuração
da conexão com o banco de dados. Contêm a lista de tabelas que serão utilizadas
no processo.
Formats: Definição
dos Flat Files de origem e destino.
Transforms:
Agrupa
os componentes que serão utilizados para o processo de carga e demais
transformações nos dados. Sendo os mais utilizados:
–
Query:
Lookups, funções e demais transformações
–
SQL:
Querys livres
–
Case:
Condicional para gerar uma ou várias saídas
–
Merge:
União dos dados vindos de várias origens
–
Key_Generation: Geração da Surrogate Key
–
History_Preserving: Slowly Change Dimension 2
–
Table_Comparison: Update, SCD 1

Start
Page:
Local para o
desenvolvimento das rotinas de ETL.

Sem comentários:
Enviar um comentário